


当行业还在争论“大模型即基础设施”时,智能体 AI 的出现悄然改变了叙事。在这套新逻辑里,引擎固然重要,但调用工具、编排流程、执行代码的软件栈,其价值与推理本身不分伯仲。
Arm 显然不打算只做旁观者。在 OCP 全球峰会上,这家芯片设计公司拿出了针对智能体 AI 的新底牌——Arm AGI CPU,一款基于 Neoverse 平台、专为高并发智能体工作负载定制的处理器。他们甚至拉来了富士通、Meta 和 OpenAI 站台,共同发布了一套新的 CPU 评估方法。第三方数据更直白:其每机架性能据称可达 x86 服务器的两倍。
但这篇文章的核心,其实不在硅片,而在那堆看不见的代码里。Arm 想传递一个信号:智能体 AI 的大规模落地,基础设施战场可能正在从“单模态推理”转移到“多步骤工作流”。这时候,CPU 的瓶颈不再是大模型跑得有多快,而是编排工具时延迟有多低、检索数据时效率有多高、跑沙箱环境时有多稳——这些恰好是 Arm 在云原生生态里已经摸爬滚打多年的主场。
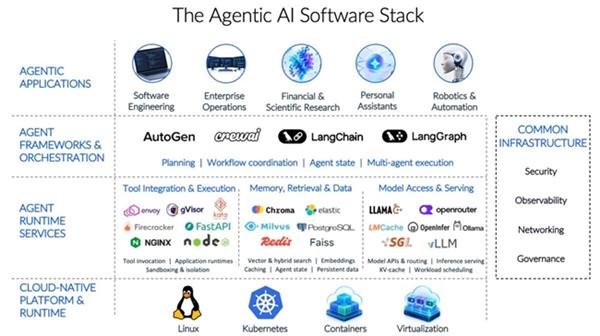
回到那套软件栈。智能体框架(LangChain/LangGraph)、编排、记忆检索(Redis/Elasticsearch)、模型服务(vLLM)等,虽非新生事物,但在智能体场景下被整合进了一个统一的流水线里。换句话说,开发者不再只是调一个 API 就完事,得把这套技术栈在 Arm64 上从头到尾跑通、跑快。为此,Arm 还上线了专门的软件仪表板,方便查兼容性。
并不是所有智能体干一样的活。编程智能体灌代码、跑测试,依赖强劲的 CPU 和可靠的隔离沙箱;企业工作流智能体偏好数据库事务和 API 交互;研究型智能体则围着搜索和检索转。这意味着,评估基础设施时盯着“跑分”没用,得实打实看完整工作链的执行效率。
Arm 显然在做局部的性能优化。据 Signal65 的独立数据,Arm AGI CPU 在沙箱创建环节的时延比 AMD EPYC 9965 低了 45%。Elasticsearch 的基准测试也指向利于 Arm 架构的结果。更值得注意的是,在 Redis 向量的搜索对比里,AWS Graviton5 在正常负载下每美元完成上下文获取次数比 x86 多出 16% 到 27%,高负载下差距拉大到 27%。这种性价比叙事,对于预算敏感的数据中心客户而言,信号很直接。
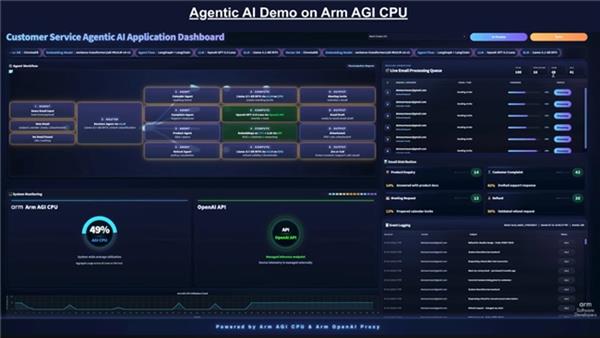
Arm 自己还在内部折腾了一个多智能体客户服务演示。用 CPU 载着的小语言模型做分类,再调动一系列专用智能体完成排会、投诉、退款。整个链条里,CPU 推理、企业数据检索、外部 API、外加工具执行,全栈跑在自己架构上。像是一场不露声色的“我也行”展示,但从软件成熟度来看,生态准备度确实已到门槛。
如今,AI 开发者不需要再从零折腾适配。Arm 已经准备好了 Learning Paths 教程,从 llama.cpp 搭代理到 FAISS 做 RAG,从 Firecracker 隔离执行到 vLLM 模型部署,都有章节可循。AWS 的 Graviton 技能计划,加上 Arm 在龙蜥社区贡献的 Performix 工具链,都在用 AI 开发工作流覆盖平台的迁移与优化知识。
回顾整个智能体 AI 兴起的节点,或许值得留意的是:当模型能力开始趋同,支撑这些模型运转的“外围计算”,正从幕后走向台前。Arm 抓住了这个窗口——它不再只是手机芯片的影子,而是服务器端一场关于编排与效率的新牌局。

作者:Arm 服务器生态系统开发总监 Bhumik Patel