


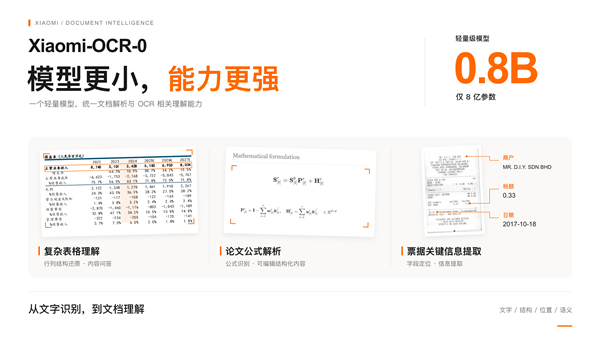
小米技术日前宣布正式发布并开源轻量级全能文档理解模型Xiaomi-OCR-0,官方给它的定位是“小尺寸全能王”。这个模型只有0.8B(8亿)参数,却同时集成了文档解析、关键信息抽取、OCR视觉问答三大核心能力,在多项基准测试中拿到了不错的成绩。
和传统OCR主要做文字识别不同,Xiaomi-OCR-0的侧重点在于“理解”——不仅能认出文档里的字,还能解析复杂结构和内容,把识别升级成理解。
具体来看三大能力:文档解析方面,可精准识别并还原正文、复杂表格和数学公式,按自然阅读顺序生成结构化结果,支持Markdown、LaTeX等格式输出;关键信息抽取方面,能从发票、收据、卡证及业务表单中提取指定字段,直接生成JSON等结构化数据;OCR视觉问答方面,支持围绕文档、图表内容做信息检索、数值计算和语义推理,实现对视觉文本的深度理解。
性能数据是这次发布里比较有看点的部分。根据小米公布的测试结果,Xiaomi-OCR-0在Real5-OmniDocBench基准测试中取得95.24分,在参与对比的模型中排名第一;在OmniDocBench v1.6综合测试中以96.83分排名总榜第二,在1B以下模型中位列第一。此外,在五项主流OCR视觉问答基准测试中,该模型取得83.2分的平均成绩,超过部分参数规模更大的模型,包括8B参数的MiniCPM-V-4.5。


据了解,Xiaomi-OCR-0基于Qwen3.5-0.8B-Base构建,训练使用了约1.7亿条高质量OCR与文档理解样本。

落地层面,相关技术正融入小米手机和超级小爱的日常使用场景,可实现取餐码提取、账单智能记账、卡证信息识别以及日程创建等功能。对普通用户来说,这些是能直接感知到的便利;对开发者而言,小米现已开源模型权重、推理代码,并提供浏览器交互式Demo、MCP服务及Agent Skill工具包,接入门槛进一步降低。


从商业角度看,0.8B这个参数规模值得琢磨。文档理解类任务过去往往依赖更大的模型,成本和部署门槛都不低,而小尺寸模型如果能在关键指标上站住脚,意味着端侧和低成本场景有了更多想象空间。小米选择开源权重和工具链,一方面是在建生态,另一方面也把文档智能这块能力推向了更多中小开发者。至于“小尺寸全能王”这个称号能不能坐稳,最终还要看实际接入后的表现。


