


机械革命“大师之路X10”发布:把大模型留在你的桌面上
AI大模型进化得飞快,云端服务也确实方便,但你把一份机密文件丢给云端处理时,心里难免会咯噔一下:这数据,到底算谁的?
当“隐私”和“算力”成为一对难以调和的矛盾,一个新的品类开始冒头——本地AI终端。机械革命刚刚发布的“大师之路X10”高性能迷你主机,就是冲着这个需求来的。
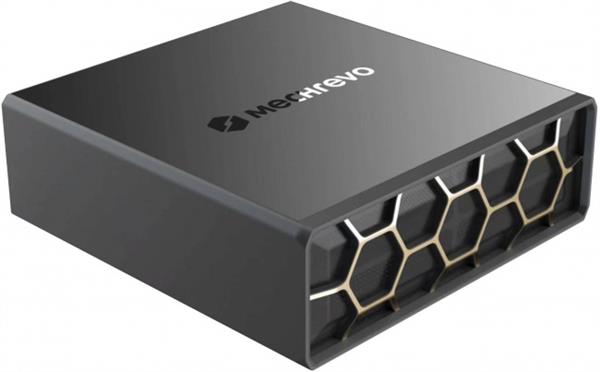
这台机器搭载了NVIDIA RTX Spark超级芯片。看参数不难看出它的野心:20核Arm v9.2 Grace定制效核CPU,Blackwell架构GPU,6144个CUDA核心,再加上128GB LPDDR5X 9600统一内存。一句话总结:它把一块高性能GPU和超大内存,塞进了一个迷你主机箱里。
用机械革命的说法,这不是一台普通的迷你主机,而是一个“本地AI算力终端”。对于开发者来说,这个终端最友好的地方在于它跑在NVIDIA CUDA平台上。今天整个AI技术圈的软件生态,几乎都是围绕CUDA构建的,新的AI模型、新的AI框架,第一天就会登陆CUDA。换句话说,你昨天在新闻里看到的那些AI新玩法,今天就可以在这台小主机里本地跑起来,数据不用上传,代码也不用改太多。
对游戏玩家而言,RTX Spark也没亏待你。DLSS、Reflex、光线追踪三个“老朋友”都在,光追游戏可以开,帧率也可以很漂亮。而这一波操作背后,是机械革命与NVIDIA在RTX Spark新形态AI PC上的深度合作,双方显然不只是“买芯片、装机箱”那么简单。


不过,这台机器真正让编辑感兴趣的,是机械革命为它准备的一颗“科技与狠活”——自研AI SSD。
本地跑大模型,最大的瓶颈是内存。大模型的参数动辄几十上百B,也就是几百GB的权重文件,光靠内存根本塞不下。显卡厂商的常规方案是把模型塞进显存,但显存容量有限,死贵还不好买。机械革命用AI SSD来做“外挂”,把一部分权重数据放进SSD里,通过高速换入换出,让电脑“跑得动”原本跑不动的超大模型。
官方给出的数字是:支持80B、120B和122B超大模型流畅运行。注意,这里说的是“流畅运行”,不是“勉强能跑”。这意味着,你可以在本地和百亿参数级别的模型对话,让它帮你写代码、做图,而整个过程中,数据始终留在你的硬盘上,一步都没有离开你的桌子。


如果我们把时间线拉长,就会发现机械革命这一波操作并不突然。此前,它已经有几款AI PC产品通过了国家终端智能化L3等级认证,是国内首批拿到这个认证的电脑品牌之一。在2026网易未来大会上,机械革命创始人潘春节留下了一句结语:“让AI,触手可及!”
这句话放在两年前可能只是一个口号,现在却正在变成现实。过去,我们要用大模型,得打开浏览器,把数据传给千里之外的服务器;现在,一台迷你主机就能把几百亿参数的模型按在本地运行。这背后当然不只是机械革命一家的功劳——NVIDIA的RTX Spark超级芯片、CUDA生态、以及整个AI基础设施的成熟,都在推动同一件事:让AI更安全、更好用、更经济地待在用户身边。


当AI大模型加速从云端走向本地,机械革命已经把新形态的AI PC摆上了桌面。至于它到底能不能成为普通人的第一台本地AI设备?后续的价格和实测,才是真正的回答。不过,至少方向已经对了。